1.4. 多层感知器MLP(人工神经网络)实现手写数字识别(图像多分类)
本文承接自上一篇文章 1.3. 利用Keras实现多层感知器MLP(人工神经网络),建议先看上一篇文章。
1.4.1. MNIST数据集
在这篇文章中我们会使用MNIST数据集建立MLP模型,实现手写数字0~9的识别。
MNIST(Modified National Institute of Standards and Technology)数据集是一个用于训练和测试机器学习模型的手写数字识别数据集。它由 70,000 张灰度图像组成,其中:
- 训练集(Training Set):60,000 张图片
- 测试集(Test Set):10,000 张图片
每张图片都是 28×28 像素的灰度图,表示一个手写数字(0-9 之间)。数据集中的标签(Label)是 0 到 9 之间的整数,表示图像中手写的数字类别。
我们选用它的原因在于:
- 标准化:所有图像的尺寸一致(28×28 像素)
- 简单易用:适合作为深度学习入门数据集
- 广泛应用:用于测试各种机器学习、深度学习模型的性能,如 CNN(卷积神经网络)、SVM(支持向量机)等
1.4.2. 准备工作
本文会使用到keras、tensorflow和matplotlib,如果没有请下载。
在终端输入指令以下载和安装:
pip install keras tensorflow matplotlib
1.4.3. 敲代码
Step 1: 导入MNIST数据集的数据
Keras中包含了MNIST数据集,所以我们就可以直接导入:
from keras.datasets import mnist
(x_train, y_train),(x_test, y_test) = mnist.load_data()
第一次使用数据集程序会先从官网下载资源,需要等一会儿。我们可以看看数据的一些信息:
print(type(x_train), x_train.shape)
<class 'numpy.ndarray'> (60000, 28, 28)
- 其类型是
numpy数组 - 有60000个样本,每一个都是28乘28像素
我们可以使用matplotlib来查看里面的数据长什么样:
# 可视化输入数据
from matplotlib import pyplot as plt
plt.imshow(x_train[0])
plt.show()
输出图像:
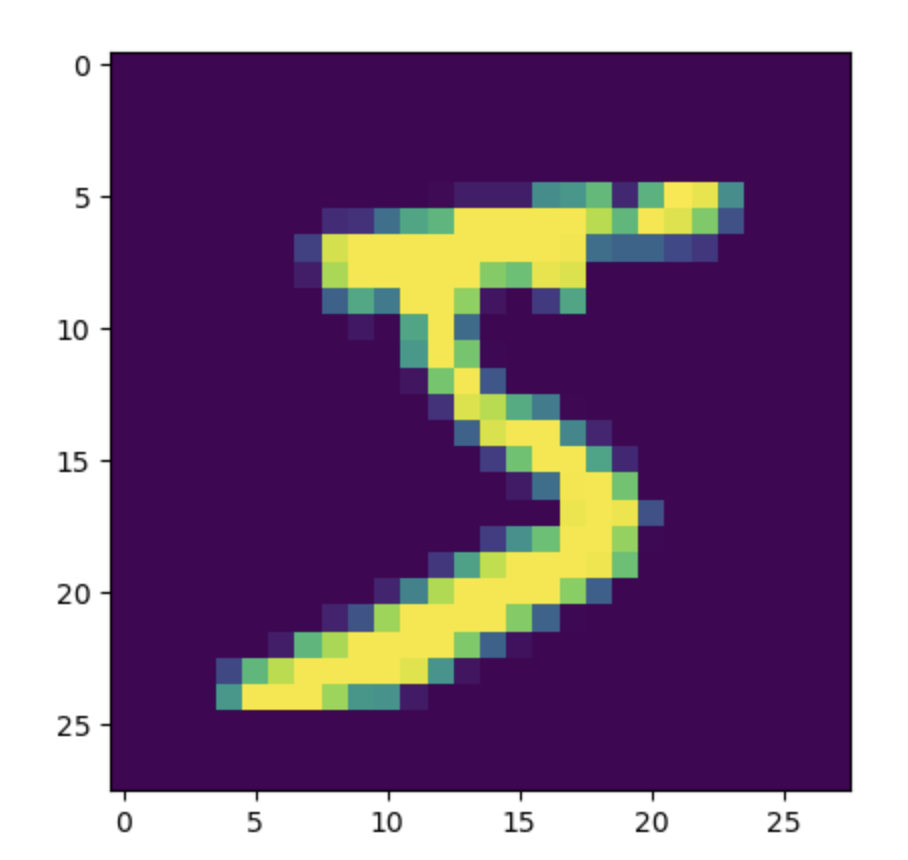
Step 2: 数组转换
我们需要把每个图片从28行28列的二维数组转为有784个元素的一维数组供MLP接收:
# 转化数据
feature_size = x_train.shape[1] * x_train.shape[2]
x_train = x_train.reshape(x_train.shape[0], feature_size)
x_test = x_test.reshape(x_test.shape[0], feature_size)
- 原始形状是
(样本数量, 高, 宽),表示每张图片的数据,转换后形状为(样本数量, 特征大小),所有像素铺平成一维的特征向量,使每张图片可以作为一个样本供模型处理 feature_size对应特征大小,也就是单张图的像素个数,用x_train.shape[1] * x_train.shape[2]即可得到reshape是 NumPy 包中用于调整数组形状的方法,常应用于调整矩阵或张量的数据维度,而不改变数据本身。这个方法不会修改原数组,而是返回一个新的数组(与原数据共享内存)
我们可以打印出此时数据的结构:
print(x_train.shape)
输出:
(60000, 784)
Step 3: 数据归一化
MNIST数据集中的图像是8bit灰度图,像素点的值区间是0~255,在MLP模型中使用到的非线性激活函数,比如sigmoid、tanh 或 ReLU,它们对数值范围敏感。所以我们需要进行归一化,把数据的范围缩小。
一般来说把像素点的灰度值除以255即可,这样就能让值保持在0到1之间,更适于MLP模型:
# 数据归一化
x_train = x_train.astype('float32')
x_test = x_test.astype('float32')
x_train /= 255
x_test /= 255
astype('float32'):MNIST 数据集的像素值在加载后为整型 (0~255 的整数)astype('float32')将它们转换为浮点型数据,以便进行更精确的数学运算(如归一化和梯度更新)x_train /= 255和x_test /= 255:将像素值除以 255,使其范围从原本的[0, 255]被压缩到[0, 1]
Step 4: 转换标签的格式
模型的输出标签会是one-hot编码:每个类别分配一个位置,将特定类别的位置置为1,其余位置为 0。假设有3个类别:A、B和C,那么:
- 类别
A的编码是[1, 0, 0]; - 类别
B的编码是[0, 1, 0]; - 类别
C的编码是[0, 0, 1]。
原本标签的格式是整数标签:比如图片里是手写的5,那对应的标签值就是5。
这两者的保存格式不一样就会给对比标签评估模型的操作带来麻烦。我们需要把原本的整数标签改为one-hot编码。
假如我们的标签是5,我们需要把“5”以这种方式保存:
[0, 0, 0, 0, 0, 1, 0, 0, 0, 0]
想要表示5就在第6位(第一位是0,所以每个数字的落位都要后移1位)写1,其余为0
keras提供了转化标签格式的函数to_categorical:
# 转换标签的格式
from keras.utils import to_categorical
y_train = to_categorical(y_train)
y_test = to_categorical(y_test)
Step 5: 建立模型
完成上文所说的所有数据预处理工作之后就可以建立模型了!我们的输入有784个(对应像素数量),第二层我们要减半到392个神经元,第三层仍然保持392个神经元;第四层,也就是输出层,得有10个输出神经元,对应0~9:
# 建立模型
from keras.models import Sequential
from keras.layers import Dense

model = Sequential()
model.add(Dense(units=392, activation='sigmoid', input_dim=feature_size))
model.add(Dense(units=392, activation='sigmoid'))
model.add(Dense(units=10, activation='softmax'))
-
units=392:表示该层有 392 个神经元(隐藏节点) -
input_dim=feature_size:输入维度,表示该层接受的数据有多少个特征。对应之前输入层形状(样本数, feature_size),即feature_size = 784(MNIST 数据的每张图片转成特征向量后有 784 个像素点)。从第二层开始并不需要显式声明input_dim,因为它会自动从上一层(第一个隐藏层)的输出中推断输入形状。 -
Softmax激活函数将输出神经元的值(logits)映射为概率分布,适用于多分类问题
使用summary方法来展示一下结构:
model.summary()
输出:
Model: "sequential"
┏━━━━━━━━━━━━━━━━━━━━━━━━━━━━━━━━━┳━━━━━━━━━━━━━━━━━━━━━━━━┳━━━━━━━━━━━━━━━┓
┃ Layer (type)                    ┃ Output Shape           ┃       Param # ┃
┡━━━━━━━━━━━━━━━━━━━━━━━━━━━━━━━━━╇━━━━━━━━━━━━━━━━━━━━━━━━╇━━━━━━━━━━━━━━━┩
│ dense (Dense)                   │ (None, 392)            │       307,720 │
├─────────────────────────────────┼────────────────────────┼───────────────┤
│ dense_1 (Dense)                 │ (None, 392)            │       154,056 │
├─────────────────────────────────┼────────────────────────┼───────────────┤
│ dense_2 (Dense)                 │ (None, 10)             │         3,930 │
└─────────────────────────────────┴────────────────────────┴───────────────┘
 Total params: 465,706 (1.78 MB)
 Trainable params: 465,706 (1.78 MB)
 Non-trainable params: 0 (0.00 B)
Step 6: 配置模型
在配置时我们就可以选择这个模型是二分类还是多分类、使用什么优化器算法:
# 配置模型
model.compile(loss='categorical_crossentropy', optimizer='adam', metrics=['accuracy'])
-
compile是 Keras 模型的方法,用于在训练模型之前配置模型的学习过程,它的主要参数有:- 损失函数(
loss):定义模型训练时计算误差的方法。 - 优化器(
optimizer):决定模型的参数(如权重和偏置)如何更新,以最小化损失函数。 - 评估指标(
metrics):决定用于评估模型性能的指标,这些指标不会影响模型训练,只用于衡量效果。
- 损失函数(
-
loss='categorical_crossentropy':categorical_crossentropy(类别交叉熵)是多分类任务中常用的损失函数 -
optimizer='adam':adam(Adaptive Moment Estimation)是一种自适应学习率优化算法,是深度学习中最常用的优化器之一 -
metrics=['accuracy']:指定模型在训练和评估时用准确率来衡量性能
Step 7: 训练模型
我们只需要把训练集数据喂给模型即可:
# 训练模型
model.fit(x_train, y_train, epochs=10)
epochs参数控制迭代次数。
如果和上一篇文章相比,我们这次选的迭代次数并不多(上次定的是3000次迭代,这次只有10),这是因为我们的图像数据非常多(60000个),不需要很多次迭代就能得到很好的效果。但是每一次迭代花费的时间就会比较久。
Step 8: 模型评估
我们使用准确率来评估模型。
由于 Step 4 已将标签转为 one-hot 编码,评估时可以用 argmax 把预测概率和真实标签都还原成类别编号,再比较是否一致:
# 训练集准确率
import numpy as np
y_train_predict = model.predict(x_train)
y_train_pred_classes = np.argmax(y_train_predict, axis=1)
y_train_true_classes = np.argmax(y_train, axis=1)
train_accuracy = np.mean(y_train_pred_classes == y_train_true_classes)
print("训练集准确率:", train_accuracy)

# 测试集准确率
y_test_predict = model.predict(x_test)
y_test_pred_classes = np.argmax(y_test_predict, axis=1)
y_test_true_classes = np.argmax(y_test, axis=1)
test_accuracy = np.mean(y_test_pred_classes == y_test_true_classes)
print("测试集准确率:", test_accuracy)
np.argmax(..., axis=1):对每一行取概率最大的类别下标。例如预测[0.1, 0.8, 0.1, ...]会得到类别1- 将预测类别与真实类别逐样本比较,再用
np.mean统计正确比例,即为准确率
输出:
训练集准确率: 0.9979166666666667
测试集准确率: 0.9808